

MATEMATYCZNE MODELE POPULACJI PSZCZÓŁ RÓŻNYCH RAS
tekst: Leon Bornus, Michał Gromisz
Pszczelnicze Zeszyty Naukowe, Rok XIII, 1969 — Leon Bornus, Michał Gromisz
strona 73PSZCZELNICZE ZESZYTY NAUKOWE ROK XIII, Nr 1—2—3 GRUDZIEŃ 1969
МАТЕМАТИЧЕСКИЕ МОДЕЛЬИ ПОПУЛЯЦИИ ПЧЕЛ РАЗНЫХ РАС
Leon Bornus i Michał Gromisz
Oddział Pszczelnictwa IS
WPROWADZENIE
Charakterystykę większej lub mniejszej populacji pszczoły miodnej opieramy najczęściej na oznaczeniu kilku cech, zwykle morfologicznych a rzadziej biologicznych. Różnice w wartości tych cech pozwalają na wyodrębnienie ras czy typów pszczoły. Analiza poszczególnych cech oddzielnie utrudnia jednoznaczną ocenę stopnia podobieństwa czy odrębności zestawianych populacji pszczoły. Na przeprowadzenie charakterystyki na podstawie zespołu cech pozwala natomiast metoda dendrytów wrocławskich, opracowana w Instytucie Matematyki PAN we Wrocławiu (Florek i inni 1951. Perkal 1953). Została ona wykorzystana w pracach Oddziału Pszczelnictwa IS nad badaniami morfometrycznymi pszczół z obszaru Polski i z poza naszego kraju (Bornus, Demianowicz, Gromisz 1966, Gromisz 1967 a, 1967 b). Zastosowano ją z pewnym też powodzeniem do określania stopnia podobieństwa pomiędzy krajowymi liniami hodowlanymi pszczół, zarówno w związku ze zróżnicowaniem geograficznym jak i w obrębie pojedynczych pasiek oraz między poszczególnymi pokoleniami materiału selekcjonowanego (Bornus, Gromisz, Weliczkow 1967).
Opracowanie matematyczno-statystyczne materiału do dendrytu wrocławskiego jest pracochłonne. Często przerasta możliwości przeciętnej placówki badawczej, nastawionej na prace o wybitnie użytkowym znaczeniu. Poza tym metoda ta pozwala na opracowanie możliwie dość licznego zbioru rojów, ale zamkniętego. Wyklucza zatem możliwość doraźnej oceny pojedynczego roju. W celu uzyskania oceny takiego roju trzeba go włączyć do zbioru rojów i dopiero opracowanie matematyczne całego zbioru dostarczy poszukiwanej informacji. W praktyce takie postępowanie jest na ogół trudne do realizowania i bardzo kosztowne. Metoda dendrytów
strona 74
wrocławskich nie może być zatem w pełni wykorzystana w hodowli i w selekcji pszczół.
Wychodząc jednak z metody dendrytów wrocławskich podejmujemy próbę opracowania wzoru na doraźną ocenę pojedynczych rojów pszczół w stosunku do całej ich populacji. W naszych oznaczeniach uwzględniliśmy wyłącznie cechy morfologiczne, lepiej od innych poznane i opracowane, chociaż do charakteryzowania zbioru rojów równie dobrze nadają się cechy biologiczne. Do opracowania wybrano trzy typy pszczół: Apis mellifica mellifica L., Apis mellifica carnica Pollm. i Apis mellifica caucasica Gorb. aktualnie cieszące się dużym zainteresowaniem na terenie Polski.
MATERIAŁ I METODA
Materiał wzięto częściowo z opracowania wcześniej opublikowanego, charakteryzującego pszczołę krajową i pszczoły z dorzecza Dunaju (Gromisz 1967 a). Ze zbioru 210 rojów porządkowanych metodą wrocławskich dendrytów wybrano do tego opracowania dwie grupy po 22 roje każda, jako typowe pod względem morfologicznym dla A. m. mellifica i A. m. carnica. Trzecią grupę rojów A. m. caucasica stanowią pszczoły od matek importowanych z ZSRR w 1968 r. Ogółem wybrano do porównania 66 rojów.
W charakterystyce morfologicznej pszczół uwzględniono 5 cech: sumę szerokości III i IV tergitu odwłokowego, długość języczka, długość przedniego skrzydła, powierzchnię lusterka woskowego, indeks kubitalny. Do obliczeń wykorzystano wartości średnie dla rojów. Oznaczanie wartości średnich oparto na pomiarach biometrycznych 30 egzemplarzy w 1 próbie pszczół z każdego roju (Gromisz 1967 a).
Dla wszystkich trzech grup rojów obliczono średnie arytmetyczne (x̄), zmienność (S²) i standardowe odchylenia (S) każdej cechy. Następnie przeprowadzono normalizację poszczególnych cech dla rojów według metody opracowanej przez matematyków wrocławskich (Florek i inni 1951, Perkal 1953) i stosowanej w opracowaniach populacji pszczół przez Oddział Pszczelnictwa IS (Bornus, Demianowicz, Gromisz 1966, Gromisz 1967 a, b). W dalszej kolejności określano stopień podobieństwa między rojami zbioru na podstawie zespołu cech. Wskaźnik podobieństwa pojedynczej cechy symbolizowano przez y, natomiast średni wskaźnik dla zespołu cech — przez ȳ.
WYNIKI
Trzy grupy rojów, które przyjęto jako typowe dla Apis mellifica mellifica L., Apis mellifica carnica Pollm i Apis mellifica caucasica
strona 75Gorb., charakteryzują się następującymi wartościami 5 badanych cech:
| A. m. mellifica: x | A. m. mellifica: S | A. m. carnica: x | A. m. carnica: S | A. m. caucasica: x | A. m. caucasica: S | |
|---|---|---|---|---|---|---|
| Suma szerokości III i IV tergitu mm | 4,911 | 0,0469 | 4,665 | 0,0490 | 4,683 | 0,0574 |
| Długość języczka mm | 6,107 | 0,0424 | 6,491 | 0,0632 | 7,046 | 0,0671 |
| Długość skrzydła mm | 9,376 | 0,0656 | 9,201 | 0,0361 | 9,442 | 0,0447 |
| Powierzchnia lusterka woskowego mm² | 2,733 | 0,0387 | 2,353 | 0,0624 | 2,293 | 0,0557 |
| Indeks kubitalny | 63,5 | 2,52 | 45,9 | 2,68 | 53,7 | 2,43 |
O różnicach między podgatunkami informują wartości średnie (x) poszczególnych cech, a o ich zmienności wewnątrz grup rojów poszczególnych podgatunków — standardowe odchylenie (S). W naszym opracowaniu zajmiemy się przede wszystkim zmiennością cech pszczół wewnątrz podgatunków.
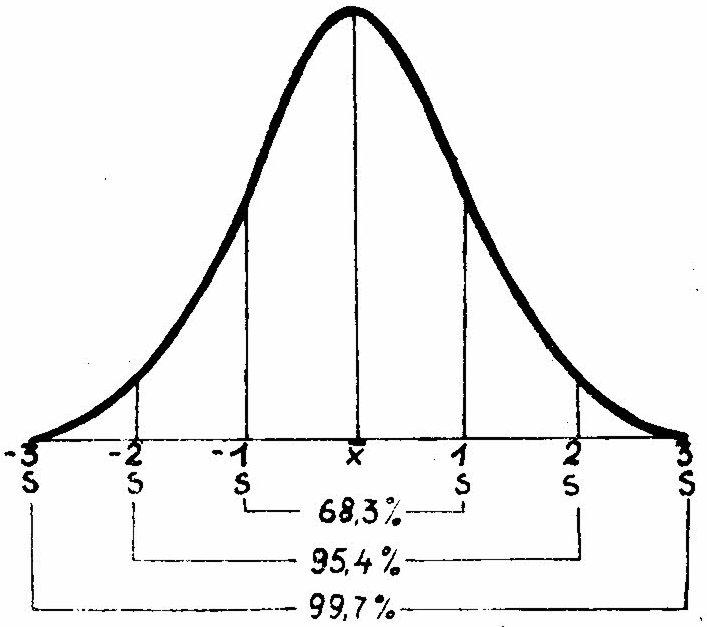
Standardowe odchylenie daje wyobrażenie o kształtowaniu się wartości cechy w danej populacji pszczoły, którą w naszym przykładzie reprezentuje próba złożona z 22 rojów. Około 68% rojów tej populacji skupia się przy średniej wartości cechy dla całej populacji w odległości nie większej na plus i na minus niż wartość S. W granicach podwojonej wartości S mieści się w przybliżeniu 95% rojów, a w granicach 3S — 99,7% (ryc. 1).
Nie ulega wątpliwości, iż bliższy średniej arytmetycznej jest rój oddalony od niej o wartość S, niż rój oddalony o 2S. Wyrażenie odległości liczbą wartości S jest zatem miarą stopnia podobieństwa danego roju w stosunku do średniej arytmetycznej całej populacji. Przedstawione więc liczbowo podobieństwo równe jest unormowanej wartości (w) cechy według wzoru:
strona 76w = (x — x̄) / S (1)
gdzie x̄ — wyraża średnią arytmetyczną dla próby (populacji), a x — wartość cechy dla poszczególnych rojów tej próby. Otrzymane wartości dla rojów jednej próby (populacji) zamykają się w 99,7% przypadków w granicach od —3 do +3. Obarczone są zatem znakiem plus lub minus, w zależności w jakim kierunku, dodatnim czy ujemnym, odchyla się wartość cechy roju od średniej arytmetycznej dla próby (populacji). Dla określenia stopnia podobieństwa kierunek odchylenia nie ma istotnego znaczenia. Na przykład w grupie A. m. mellifica roje nr 13 i 43, które mają wskaźniki podobieństwa pod względem długości języczka —0,9 i +0,9, znajdują się w zasadzie w takiej samej odległości, równej 0,9 S od wartości średniej dla próby. Wskaźnik podobieństwa (w) jest taki sam, i dlatego znak + lub — można pomijać. Będzie to mała modyfikacja wzoru (1) na:
y = ((x — x̄) / S) (2)
Korzyści wynikające z takiej adaptacji można zilustrować na przykładzie.
W grupie A. m. mellifica odległość roju nr 7 od wartości średniej obliczona według wzoru (1) wynosi dla poszczególnych cech: długości języczka +0,64, sumy szerokości III i IV tregitu —1,16, długości skrzydła +1,00, powierzchni lusterka woskowego —0,37, indeksu kubitalnego —2,10. Zastosowanie natomiast wzoru (2) daje w następstwie wskaźniki podobieństwa pozbawione znaku plus czy minus. Otrzymujemy zatem następujące wartości z zachowaniem tej samej kolejności cech: 0,64; 1,16; 1,00, 0,37 i 2,10. Wartości te można zsumować i obliczyć przeciętny wskaźnik podobieństwa: ȳ = 1/5 (0,64 + 1,16 + 1,00 + 0,37 + 2,10) = 1,05. W ten sposób jedną liczbą wyrażamy ocenę miejsca roju nr 7 w populacji A. m. mellifica, dokonaną na podstawie wartości 5 cech morfologicznych.
Taki wskaźnik podobieństwa (ȳ) dla roju nr 7 można przedstawić według wzoru ogólnego:
ȳ = 1/n (y_1 + y_2 + ……… + y_(n—1) + y_n),
gdzie n — wyraża liczbę cech, a oznaczenia przy y od 1 do n — kolejną ich numerację od cechy 1 do n-tej. Wzór ten można rozwinąć jeszcze dalej, korzystając z wzoru (2), mającego postać y = |(x — x̄) / S|
Otrzymamy wtedy:
ȳ = 1/n |(x_1 — x̄_1) / S_1| + |(x_2 — x̄_2) / S_2| + ….. + |(x_(n—1) — x̄_(n—1)) / S_(n—1)| + |(x_n — x̄_n) / S_n| (3)
strona 77Według tego wzoru obliczono wskaźniki podobieństwa (ȳ) dla poszczególnych rojów w każdej z trzech grup populacji rasowych. Rój nr 7 uzyskał na przykład ȳ = 1,05, pozostałe roje w grupie A. m. mellifica od ȳ = 0,28 do ȳ = 1,39. Zestawienie wyników takiego obliczenia dla wszystkich rojów przedstawia się następująco:
| 0—1,0 | 1,1—2,0 | 2,1—3,0 | |
|---|---|---|---|
| A. m. mellifica | 19 | 3 | — |
| A. m. carnica | 20 | 2 | — |
| A. m. caucasica | 17 | 5 | — |
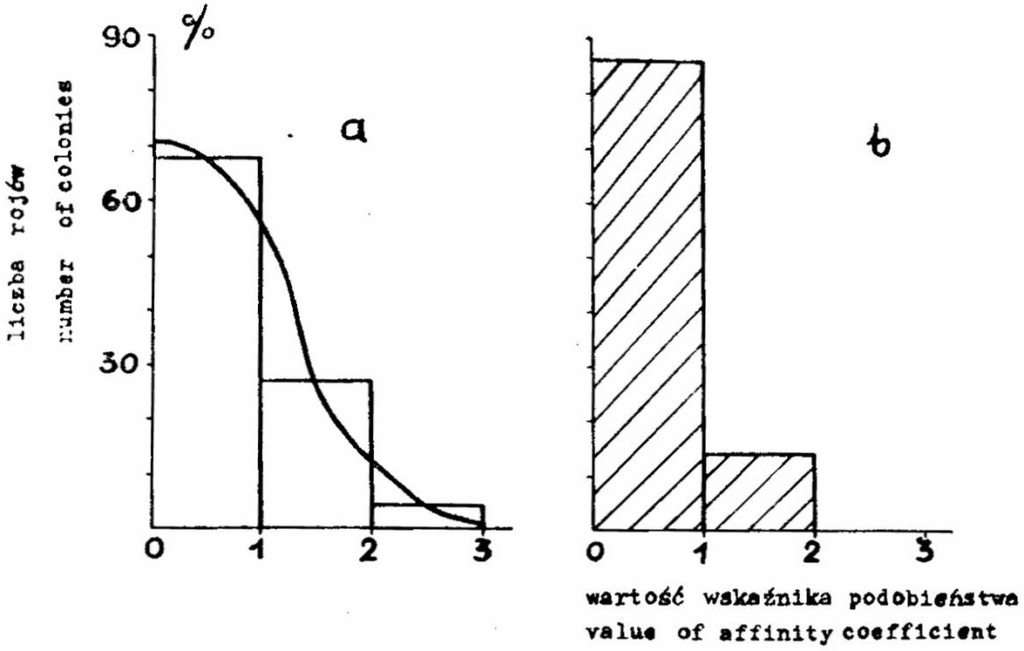
W żadnej grupie rojów podobieństwo nie przekracza wskaźnika 2,0. W populacjach szerszych, które reprezentują nasze próby, jest możliwe większe różnicowanie się wskaźników, praktycznie do 3,0, jakkolwiek rojów o wskaźnikach od 2,0 do 3,0 spotyka się mało, około 32% przy ocenie na podstawie pojedynczej cechy. Prawdopodobieństwo znalezienia w populacji roju o wskaźniku podobieństwa większym od 3,0 jest bardzo małe (około 0,03% rojów), zmniejsza się ono jeszcze w miarę powiększania zespołu cech badanych (ryc. 2). O ile zatem dany rój legitymuje się wskaźnikiem podobieństwa przekraczającym wartość 3,0, możemy śmiało kwestionować przynależność jego do określonej populacji. Ryzyko pomyłki jest tym mniejsze, im wartość wskaźnika podobieństwa jest wyższa od 3,0.
Interpretacja taka ma duże znaczenie praktyczne. Pozwala na określenie stopnia podobieństwa dowolnego roju w stosunku do populacji, której cechy są opracowane matematyczno-statystycznie na podstawie badania odpowiednio licznej grupy (próby) rojów ją reprezentujących. W obliczaniu wskaźnika podobieństwa takiego roju należy wykorzystać wartości średnie i standardowe odchylenie cech, charakteryzujące całą populację. Staje się tu pomocny wzór (3). Mając przebadaną dostatecznie reprezentatywną liczbę próbek określonej populacji pszczoły, można na podstawie naszego wzoru obliczeń przedstawić model ogólny dla tej populacji, w stosunku do którego łatwo jest określać wskaźnik podobieństwa każdego dowolnego roju. Dla naszej przykładowej grupy A. m. mellifica model obliczeniowy przybiera postać następującą:
ȳ = 1/5 [(x_t — 4,911) / 0,0469] + [(x_j — 6,107) / 0,0424] + [(x_s — 9,376) / 0,0656] + [(x_w — 2,733) / 0,0387] + [(x_k — 63,5) / 2,52]
Po wykonaniu działań otrzymamy:
ȳ = [4,2644 · x_t—20,9425] + [4,7170 · x_j—28,8067] + [3,0488 · x_s—28,5855] + [5,1679 · x_w—14,1239] + [0,0794 · x_k—5,0419] (4)
Numeracje cech, w naszym przykładzie od 1 do 5, zastąpiono symbolami: t — suma szerokości III i IV tergitu odwłokowego, j — długość języczka, s — długość skrzydła, w — powierzchnia lusterka woskowego, k — indeks kubitalny. Symbol x oznacza wartość cechy ocenianego roju. W taki sam sposób wyprowadzone modele dla dwóch pozostałych grup pszczół naszego przykładu przedstawiają się następująco:
model A. m. carnica
ȳ = [4,0816 · x_t—19,0407] + [3,1645 · x_j—20,5408] + [5,5402 · x_s—50,9754] + [3,2051 · x_w—7,5416] + [0,0746 · x_k—3,4241] (5)
model A. m. caucasica
ȳ = [3,4843 · x_t—16,3170] + [2,9806 · x_j—21,0013] + [4,4743 · x_s—42,2463] + [3,5907 · x_w—8,2335] + [0,0823 · x_k—4,4195] (6)
Dla zilustrowania przydatności tego rodzaju modeli w systematycznym określaniu rojów spróbujemy porównać wskaźnikami podobieństwa podane w naszym opracowaniu podgatunki. W tym celu pojedyncze roje o średnich wartościach cech grup A. m. carnica i A. m. caucasica podstawiamy do wzoru (4), charakteryzującego grupę A. m. mellifica. Rój z grupy A. m. carnica uzyskuje wskaźnik podobieństwa y = 6,73, a rój z A. m. caucasica y = 8,65. Oba wskaźniki są znacznie większe od 3,0, a więc trzeba wykluczyć przynależność tych rojów do grupy A. m. mellifica. Podobne obliczenia wykonane na podstawie
strona 79wzorów (5) i (6) z odpowiednim doborem rojów z 2 pozostałych podgatunków pszczół informują:
| model A. m. carnica: | rój A. m. mellifica | — ȳ=5,72 |
| rój A. m. caucasica | — ȳ=3,94 | |
| model A. m. caucasica: | rój A. m. mellifica | — ȳ=6,27 |
| rój A. m. carnica | — ȳ=3,67 |
Odrębność tych populacji w stosunku do modelu wyjściowego zaznacza się więc wyraźnie.
Na podstawie tych samych trzech modeli spróbujemy dokonać oceny rojów z pasiek: a) A. Koperwasa w Biłgoraju, b) A. Peły w Lublińcu, i c) Oddziału Pszczelnictwa IS w Dąbrowicach. Wartość cech tych rojów jest następująca:
| Nr roju | t | j | s | w | k | |
|---|---|---|---|---|---|---|
| a) | 1 | 4,980 | 6,111 | 9,588 | 2,796 | 62,0 |
| 2 | 4,947 | 6,141 | 9,405 | 2,932 | 58,6 | |
| 3 | 4,783 | 6,131 | 9,422 | 2,747 | 60,7 | |
| b) | 1 | 4,745 | 6,516 | 9,463 | 2,388 | 44,0 |
| 2 | 4,692 | 6,297 | 9,421 | 2,332 | 54,6 | |
| 3 | 4,708 | 6,313 | 9,234 | 2,331 | 45,7 | |
| c) | 1 | 4,549 | 7,023 | 9,338 | 2,505 | 60,9 |
| 2 | 4,526 | 7,089 | 9,377 | 2,404 | 59,6 | |
| 3 | 4,648 | 6,819 | 9,471 | 2,230 | 61,5 |
Wskaźniki podobieństwa dla poszczególnych rojów obliczone według wzorów (4), (5) i (6) kształtują się następująco:
| Roje | Model A. m. mellifica | Model A. m. carnica | Model A m. caucasica | |
|---|---|---|---|---|
| a) | 1 | 1,40 | 7,25 | 6,96 |
| 2 | 1,82 | 6,19 | 6,48 | |
| 3 | 1,09 | 5,21 | 5,37 | |
| b) | 1 | 6,23 | 2,11 | 3,03 |
| 2 | 4,87 | 2,66 | 3,83 | |
| 3 | 5,76 | 1,01 | 4,00 | |
| c) | 1 | 7,37 | 4,52 | 2,35 |
| 2 | 8,29 | 4,62 | 1,85 | |
| 3 | 7,53 | 4,16 | 1,80 |
U A. Koperwasa znajduje się pszczoła krajowa, u A. Peły — kraińska, a w Oddziale Pszczelnictwa IS — kaukaska. Przykład ten wskazuje, że przynależność rasową na podstawie proponowanych modeli określać nie trudno.
strona 80WNIOSKI
Zaproponowana metoda typowych modeli dla oddzielnych fenotypów pszczoły miodnej, określająca bez trudu wskaźniki podobieństwa dowolnie wybranej populacji do bardziej ogólnego typu albo rasy geograficznej, nadaje się do praktycznego zastosowania na skalę masową. Warunkiem jest jedynie wykonanie odpowiedniej liczby pomiarów, aby wiernie określić cechy tej szerokiej populacji (stworzyć model), w stosunku do której porównywane będą wszystkie dowolnie wskazane roje.
Oparcie się na metodzie matematycznej dendrytów pozwala w jednakowym stopniu posługiwać się w porównaniach cechami morfologicznymi jak i biologicznymi.
Metoda modeli daje się z powodzeniem zastosować do porównań bardzo podobnych populacji, spokrewnionych dość ściśle, a tym samym może służyć hodowli w zakresie określania zbliżenia, oddalania lub niezmienności wartości cech pokoleń selekcjonowanych w stosunku do wyjściowej grupy pszczół.
LITERATURA
Bornus L., Demianowicz A., Gromisz M. (1966) — Morfometryczne badania krajowej pszczoły miodnej Apis mellifica L. Pszczeln. Zesz. Nauk., 10 (1-4): 1—46
Bornus L., Gromisz M., Veličkov V. (1967) — Ocena linii zarodowych pszczół w Polsce metodą taksonomii wrocławskiej. Pszczeln. Zesz. Nauk., 11 (1-3): 51—60
Florek K., Łukaszewicz J., Perkal J., Steinhaus H. i Zubrzycki S. (1951) — Taksonomia Wrocławska. Przegląd Antropologiczny, 17: 193—211
Gromisz M. (1967 a) — Porównanie pszczoły Podkarpacia z pszczołami północnej Polski (Apis mellifica L.) i dorzecza Dunaju (Apis mellifica carnica Pollm.) Pszczeln. Zesz. Nauk. 11 (1-3): 1—36
Gromisz M. (1967 b) — Przydatność niektórych cech morfologicznych w systematyce wewnątrz gatunku Apis mellifica L. Pszczeln. Zesz. Nauk., 11 (1-3): 37—50
Perkal J. (1953) — Taksonomia wrocławska. Przegląd Antropologiczny, 19: 82—105
strona 81MATHEMATICAL MODELS OF BEE POPULATION OF DIFFERENT RACES
L. Bornus and M. Gromisz
Summary
Any populations of honey bee can be characterized on the bases of its morphological and/or biological features. Morphological characters were more thoroughly investigated, and they enable a more accurate and objective measurements. However, comparing of separate characters independently yealds no satisfactory results, because of multiway variability among bee races and breeding lines. Thus, there is a need for a statistical method that should integrate various dimensions to a simple coefficient of affinity.
Our laboratory for year applies such a method to valuate bee colonies and breeding lines. It has been named by the authors as „dendrite method”. This method is most suitable for arranging of large collections of samples representing f. e. population of a country or greater a geographical region. Certain elements of the method however can be used to elaborate a standard population model (a standard population of a country for example). Any colony can be subsquently compared to this standard population by means of a simple statistical computation.
Selected data for 3 geographical bee races are used to illustrate the computing procedure (tabl. 1). Each number is based on 2200 measurements (total 66 samples consisting of 100 worker bee each). The following characters were measured: size of worker bee, expressed as sum of width of III-rd and IV-th abdominal tergites, the length of the tongue, the length of the front wing, surface of wax plate on the IV-th abdominal sternite, the cubital index. Average (x̄) and standard deviation (S) values calculated in the usual way and are listed in the table.
Table 1
| Caharacters | A. m. mellifica: x̄ | A. m. mellifica: S | A. m. carnica: x̄ | A. m. carnica: S | A. m. caucasica: x̄ | A. m. caucasica: S |
|---|---|---|---|---|---|---|
| „a* Sum of widths of III and IV terg. in mm | 4,911 | 0,0469 | 4,065 | 0,0499 | 4,683 | 0,0574 |
| „b” Length of tongue mm | 6,107 | 0,0424 | 6,491 | 0,0632 | 7,043 | 0,0671 |
| „c” Length of the front wing in mm | 9,367 | 0,0656 | 9,201 | 0,0361 | 9,442 | 0,0447 |
| „d” Surface of wax plate on IV stern. in mm² | 2,733 | 0,0387 | 2,353 | 0,0624 | 2,293 | 0,0557 |
| „e” cubital index | 63,5 | 2,52 | 45,9 | 2,68 | 53,7 | 2,43 |
Further computation is based on the properties of standard deviation, and particularly on the statement that the interval ±3^b includes about 99,7% individuals of a population with zero mean and unit standard deviation. The coefficient of affinity between two populations in respect to a single character is defined as:
z = (x — x̄) / S
strona 82where x̄ and S are the average and standard deviation values of the character in general population (f. e. representing A. m. m. in our research), and x is the character value in the tested sample population (f. e. a colony). The obtained coefficient expresses the numerical distance between the model population and the tested one in standard deviation units. The formula yealds a results with the (+) or (—) sign of course, which can be ignored if necessary.
If more than one character are considered, the population affinity coefficient can be defined as an arithmetical mean of all character affinity coefficients according to the formula:
f = 1/n ∑ ((x_1 — x̄_1) / S_1)
where n = number of investigated characters, and brackets indicate that (+) and (—) sign are to be disregarded.
For example colony No 7 of the A. m. mellifica group in comparing to the general population show the following character affinity coefficient (ff: a = —1,16; b = +0,64; c = +1,OO; d = —0,37; e = —2,10). If (+) and (—) signs are ignored, the sum amounts to 5,27, which divided into 5 (number of characters) yields the population affinity coefficient f = 1,05. The calculated coefficient is very small in this case and expresses close affinity of the colony No 7 to the general population A. m. mellifica.
Those formula can be written in the developed form:
f = 1/n ((x_1 — x̄_1) / S_1) + ((x_2 — x̄_2) / S_2) + ((x_3 — x̄_3) / S_3) + (and so on)
If we substutite actual character values from table 1 for x̄’-s and S’s we obtain 3 models each suitable for comparison any colony with one of the three populations (geographical races).
Model 1 — for A. m. mellifica
F = (4,2644 · x_a—20,9425) + (4,7170 · x_b—28,8067) + (3,0488 · x_c—28,5855) + (5,1679 · x_d—14,1239) + (0,0794 · x_e—5,0419)
Model 2 — for A. m. carnica
F = (4,0816 · x_a—19,0407) + (3,1645 · x_b—20,5408) + (5,5402 · x_c—50,9754) + (3,2051 · x_d—7,5416) + (0,0746 · x_e—3,4241)
Model 3 — for A. m. caucasica
F = (3,4843 · x_a—16,3170) + (2,9806 · x_b—21,0013) + (4,4743 · x_c—42,2463) + (3,5907 · x_d—8,2335) + (0,0823 · x_e—4,4195)
The next step will be to insert numerical values of characters in a tested population for x’s and compute the population affinity coefficients.
Let us for illustration consider a colony of the A. m. carnica group with the following character values: a = 4,065, b = 6,491, c = 9,201, d = 2,353, e = 45,9. Substituting these values into the model 1 (for A. m. mellifica) we receive the population affinity coefficient F = 6,73, which considerably larger than 3 and indicates very little affinity between the compared populations. The coefficient calculated for A. m. caucasica colony in relation to the A. m. mellifica model population amounts to F = 8,65, which indicate even greaten phenotic distance than that between A. m. carnica and A. m. mellifica. In this manner one can process data for any colony to establish its phenotic relation to each of model populations.
strona 83The described method allows to compare bee populations on the basis of many number of morphological characters and/or biological features, economical ones e. t. c. The method is suitable for establishing racial relation of a colony as well as for comparing productivity of colonies descending from sisteralyqueens, for investigating of characters inheretance in subsequent generations of a selected breading line e. t. c.
The objectiveness end axactness of the estimates obtained in this method are very high degree.
Errata — błędy druku znalezione podczas digitalizacji
- s. 73, tytuł rosyjski: „МОДЕЛЬИ” → МОДЕЛИ
- s. 76: „tregitu” → tergitu
- s. 81: „yealds” → yields
- s. 81: „subsquently” → subsequently
- s. 81, tab. 1, główka: „Caharacters” → Characters
- s. 81, tab. 1, A. m. carnica, cecha a, średnia: „4,065″ → 4,665
- s. 81, tab. 1, A. m. carnica, cecha a, S: „0,0499″ → 0,0490
- s. 81, tab. 1, A. m. caucasica, cecha b, średnia: „7,043″ → 7,046
- s. 81, tab. 1, A. m. mellifica, cecha c, średnia: „9,367″ → 9,376
- s. 82: „yealds” → yields
- s. 82: „+1,OO” → +1,00
- s. 82: „substutite” → substitute
- s. 82: „a = 4,065″ → a = 4,665
- s. 82: „greaten” → greater
- s. 83: „inheretance” → inheritance
- s. 83: „breading line” → breeding line
- s. 83: „end axactness” → and exactness